Ich betreue rund 90 kleine Projekte: Kundenwebsites, ein Homelab, Nebenprojekte. Mit KI-Coding-Agenten wie Claude Code habe ich ein Problem: Jede neue Sitzung beginnt bei null. Was läuft wo? Was ist offen? Warum haben wir uns damals für Variante B entschieden? Ich habe diesen Kontext Woche für Woche neu erklärt. Deshalb habe ich AgentWorkbench gebaut und als Open Source (MIT) veröffentlicht.
Die Idee
Ein kleines Dashboard, das ich und meine Agenten gemeinsam lesen und beschreiben. Pro Projekt gibt es Aufgaben mit Priorität, Ideen, angepinnte Notizen, Dokumente und einen Verlauf. Bevor ein Agent loslegt, holt er ein kurzes Briefing als Klartext. Während der Arbeit hakt er Erledigtes ab. Am Ende schreibt er auf, was getan wurde, und hinterlässt Notizen für das nächste Mal.
Was drin ist
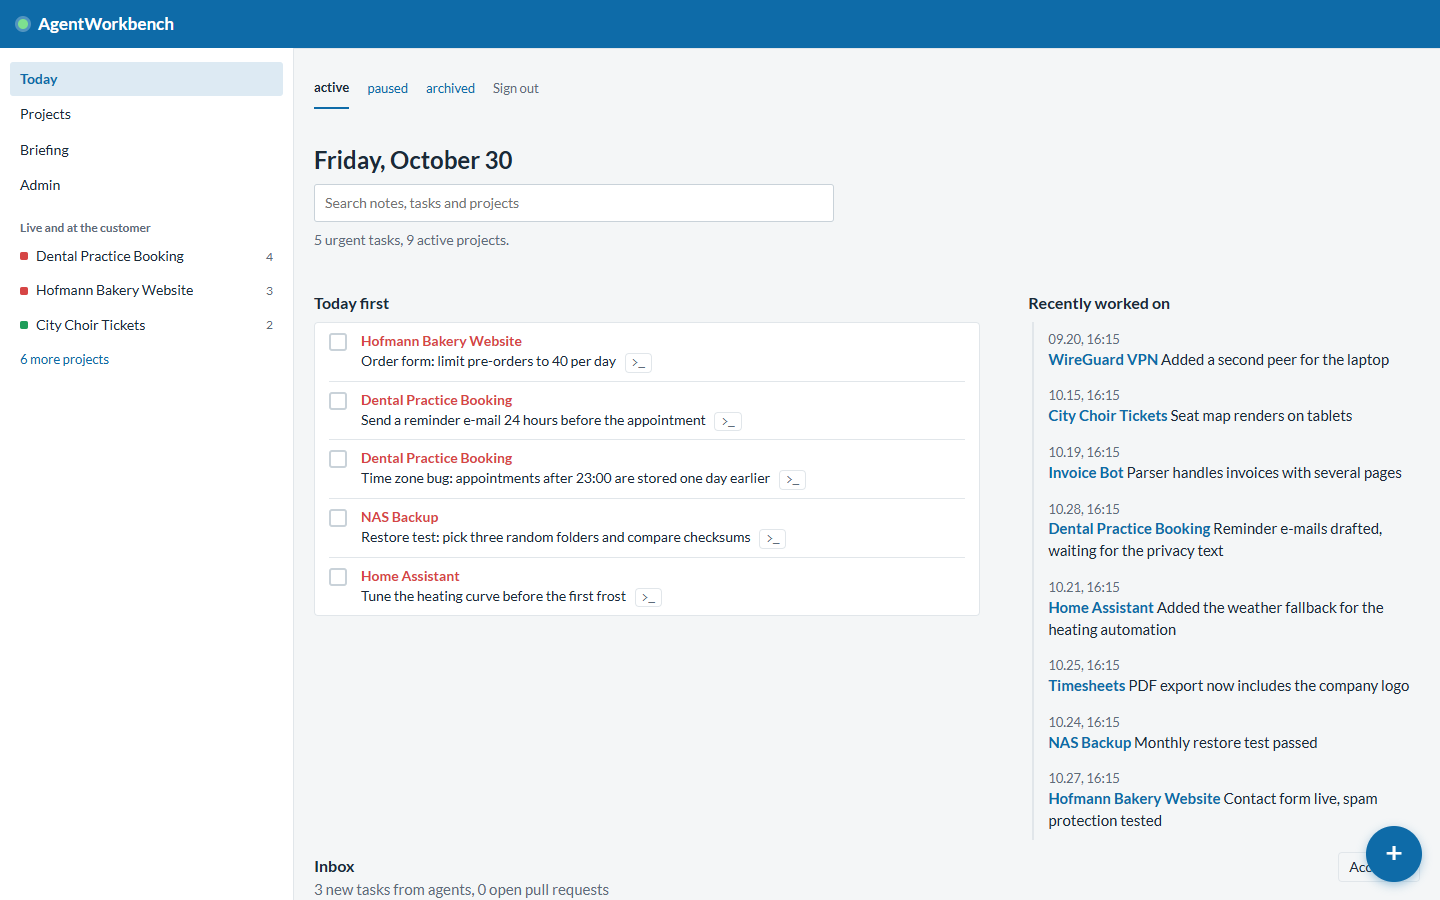
- Briefing pro Projekt über eine einfache HTTP-Schnittstelle, die jeder Agent nutzen kann, der
curlbeherrscht. Kein Plugin, kein eigener Server. Zugriff über Tokens, die sich widerrufen lassen. - Morgen-Briefing als Push-Nachricht auf dem Handy, Projekte im Betrieb zuerst.
- Prüfregeln, mit denen sich Aufgaben selbst abhaken: Seite liefert Status 200, ein Text steht auf der Seite, ein DNS-Eintrag stimmt, ein Port ist offen.
- Handy-App als PWA mit Offline-Lesen, Schnell-Eintrag und Anmeldung per Passkey.
- Optionale Proxmox-Ansicht, nur lesend: Welches Projekt läuft in welchem Container, und läuft er gerade?
Technisch ist es bewusst schlicht: ein FastAPI-Prozess, eine SQLite-Datei, kein Build-Schritt. docker compose up -d reicht. Es gibt ein Admin-Konto und keine Mehrbenutzerverwaltung. Betreiben sollte man es hinter HTTPS und am besten hinter einem Zugangsschutz. Ein Raspberry Pi genügt.
Wie der Agent es nutzt
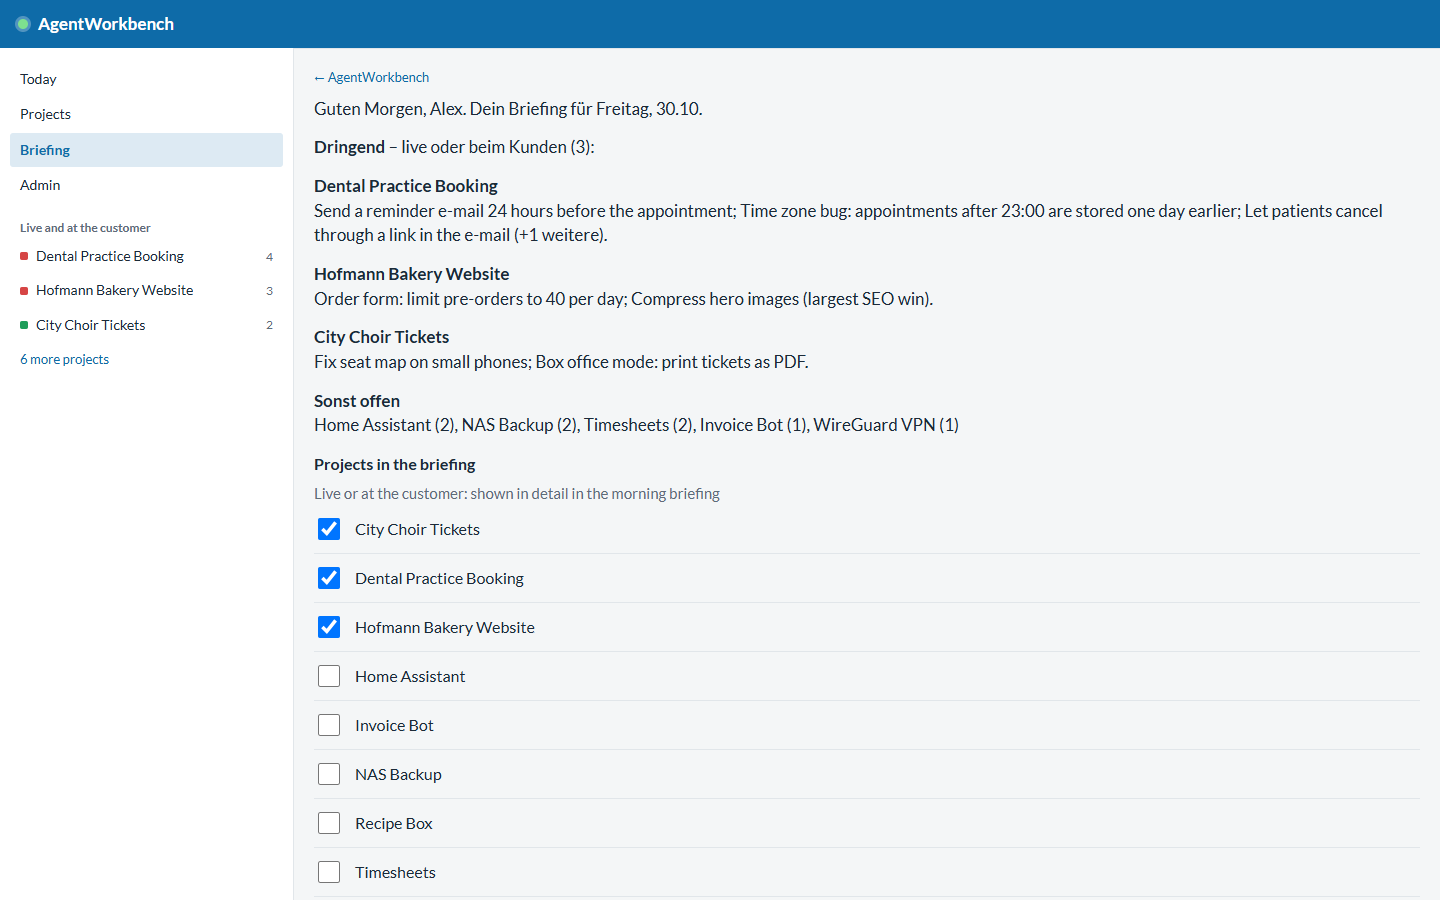
Auf der Agentenseite sind es drei Dinge: ein Skill, der die Aufrufe beschreibt, ein kurzer Abschnitt in der globalen CLAUDE.md und ein Token. Der Ablauf ist immer gleich:
- Briefing zum Projekt holen.
- Erledigte Aufgaben sofort abhaken, neue eintragen.
- Dauerhaftes Wissen als Notiz speichern: Entscheidungen samt Grund, Stolperfallen, Hinweise für das nächste Mal.
- Zum Schluss ein Verlaufseintrag, ein Satz.
Eine Regel hat sich als wichtig erwiesen: Vor der letzten Antwort einer Sitzung geht der Agent alle offenen Aufgaben durch und hakt ab, was nachweislich erledigt ist. Nachweislich heißt: Test grün, Dienst läuft, Datei vorhanden. Nicht „versucht“. Sonst driftet die Liste innerhalb weniger Tage von der Wirklichkeit weg.
Hilft es wirklich? Ich habe es gemessen
Ich wollte nicht raten, sondern nachmessen. Gleiche fünf Fragen zu meinen Projekten, gleiches Modell (Sonnet), gleiche Daten. Einmal beantwortet aus aufgeräumten Markdown-Notizen, einmal über die Schnittstelle. 25 Läufe pro Zeile.
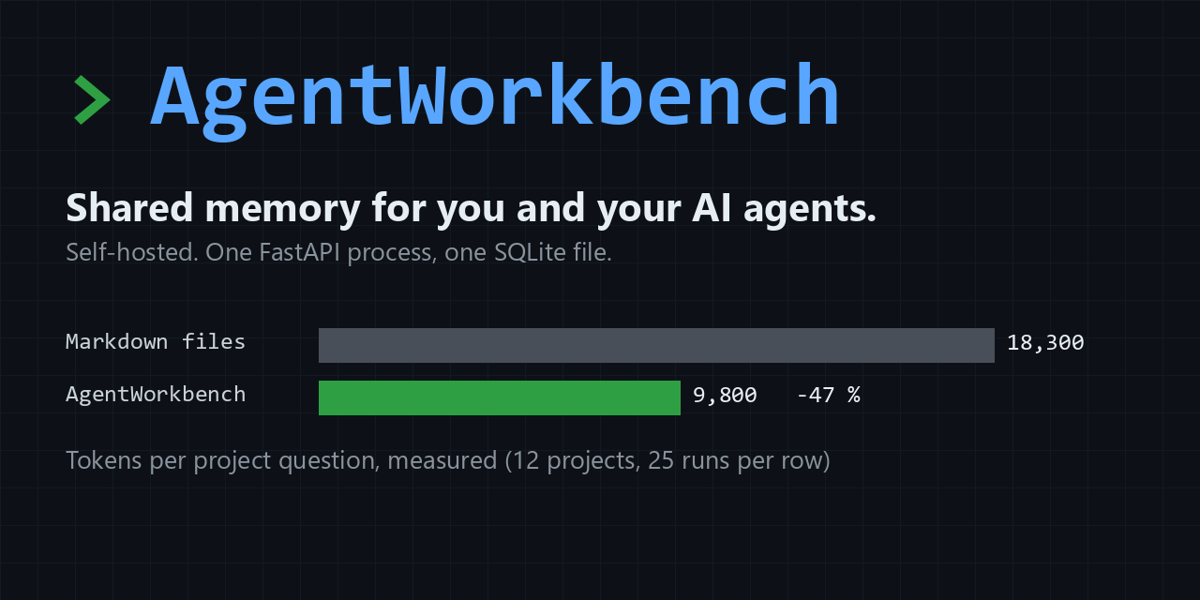
- 12 Projekte: 47 % weniger Tokens (rund 9.800 pro Frage)
- 60 Projekte: 36 % weniger Tokens (rund 12.000 pro Frage)
- Treffsicherheit in beiden Varianten gleich, 25 von 25. Der Gewinn kommt aus weniger Schritten, nicht aus kürzerem Text.
Was der Test nicht beweist
Ehrlich gesagt ist der Vergleich nicht neutral. Die Markdown-Dateien sind aufgeräumt und leicht zu durchsuchen, das begünstigt die Dateien. Die Datenmenge ist klein, es ist ein Modell und es sind nur fünf lesende Fragen. Eine einzelne Notiz nachzuschlagen war ein Unentschieden. Das Werkzeug hilft bei „Wo stehe ich?“, nicht bei „Finde diesen einen Satz“. Methode und jeder einzelne Lauf liegen im Ordner benchmark/ im Repository. Wer will, lässt run_benchmark.py mit eigenen Fragen laufen.
Was ich dabei gelernt habe
Projektübergreifende Fragen wie „Was ist überall dringend?“ waren im ersten Lauf die Schwachstelle: Der Agent musste jedes Briefing einzeln öffnen. Deshalb gibt es jetzt GET /api/todos: ein Aufruf, alle offenen Aufgaben, die dringendsten zuerst. Das wäre ohne Messung nicht aufgefallen.
Mit Claude Code gebaut
Große Teile der App sind mit Claude Code entstanden, in vielen kleinen Sitzungen. Ich schreibe das dazu, weil es dazugehört: Die Entscheidungen, was rein soll und was nicht, treffe ich. Aber ein Teil des Codes stammt vom Agenten, und der Agent ist zugleich der Hauptnutzer des Ergebnisses.
Ausprobieren
git clone https://github.com/thom7e/agentworkbench
cd agentworkbench
docker compose up -d
Mit scripts/demo_seed.py lassen sich Demodaten laden. Der Code liegt unter MIT-Lizenz auf GitHub. Rückmeldungen sind willkommen, vor allem zur Frage, ob der Benchmark fair ist und was für euer Setup fehlt. Es gibt ein paar offene Issues für den Einstieg, etwa Beispiel-Setups hinter Caddy oder Traefik, eine weitere Oberflächensprache oder einen MCP-Wrapper für die Schnittstelle.